
M6与M5 Ultra:苹果为macOS本地AI带来的潜力
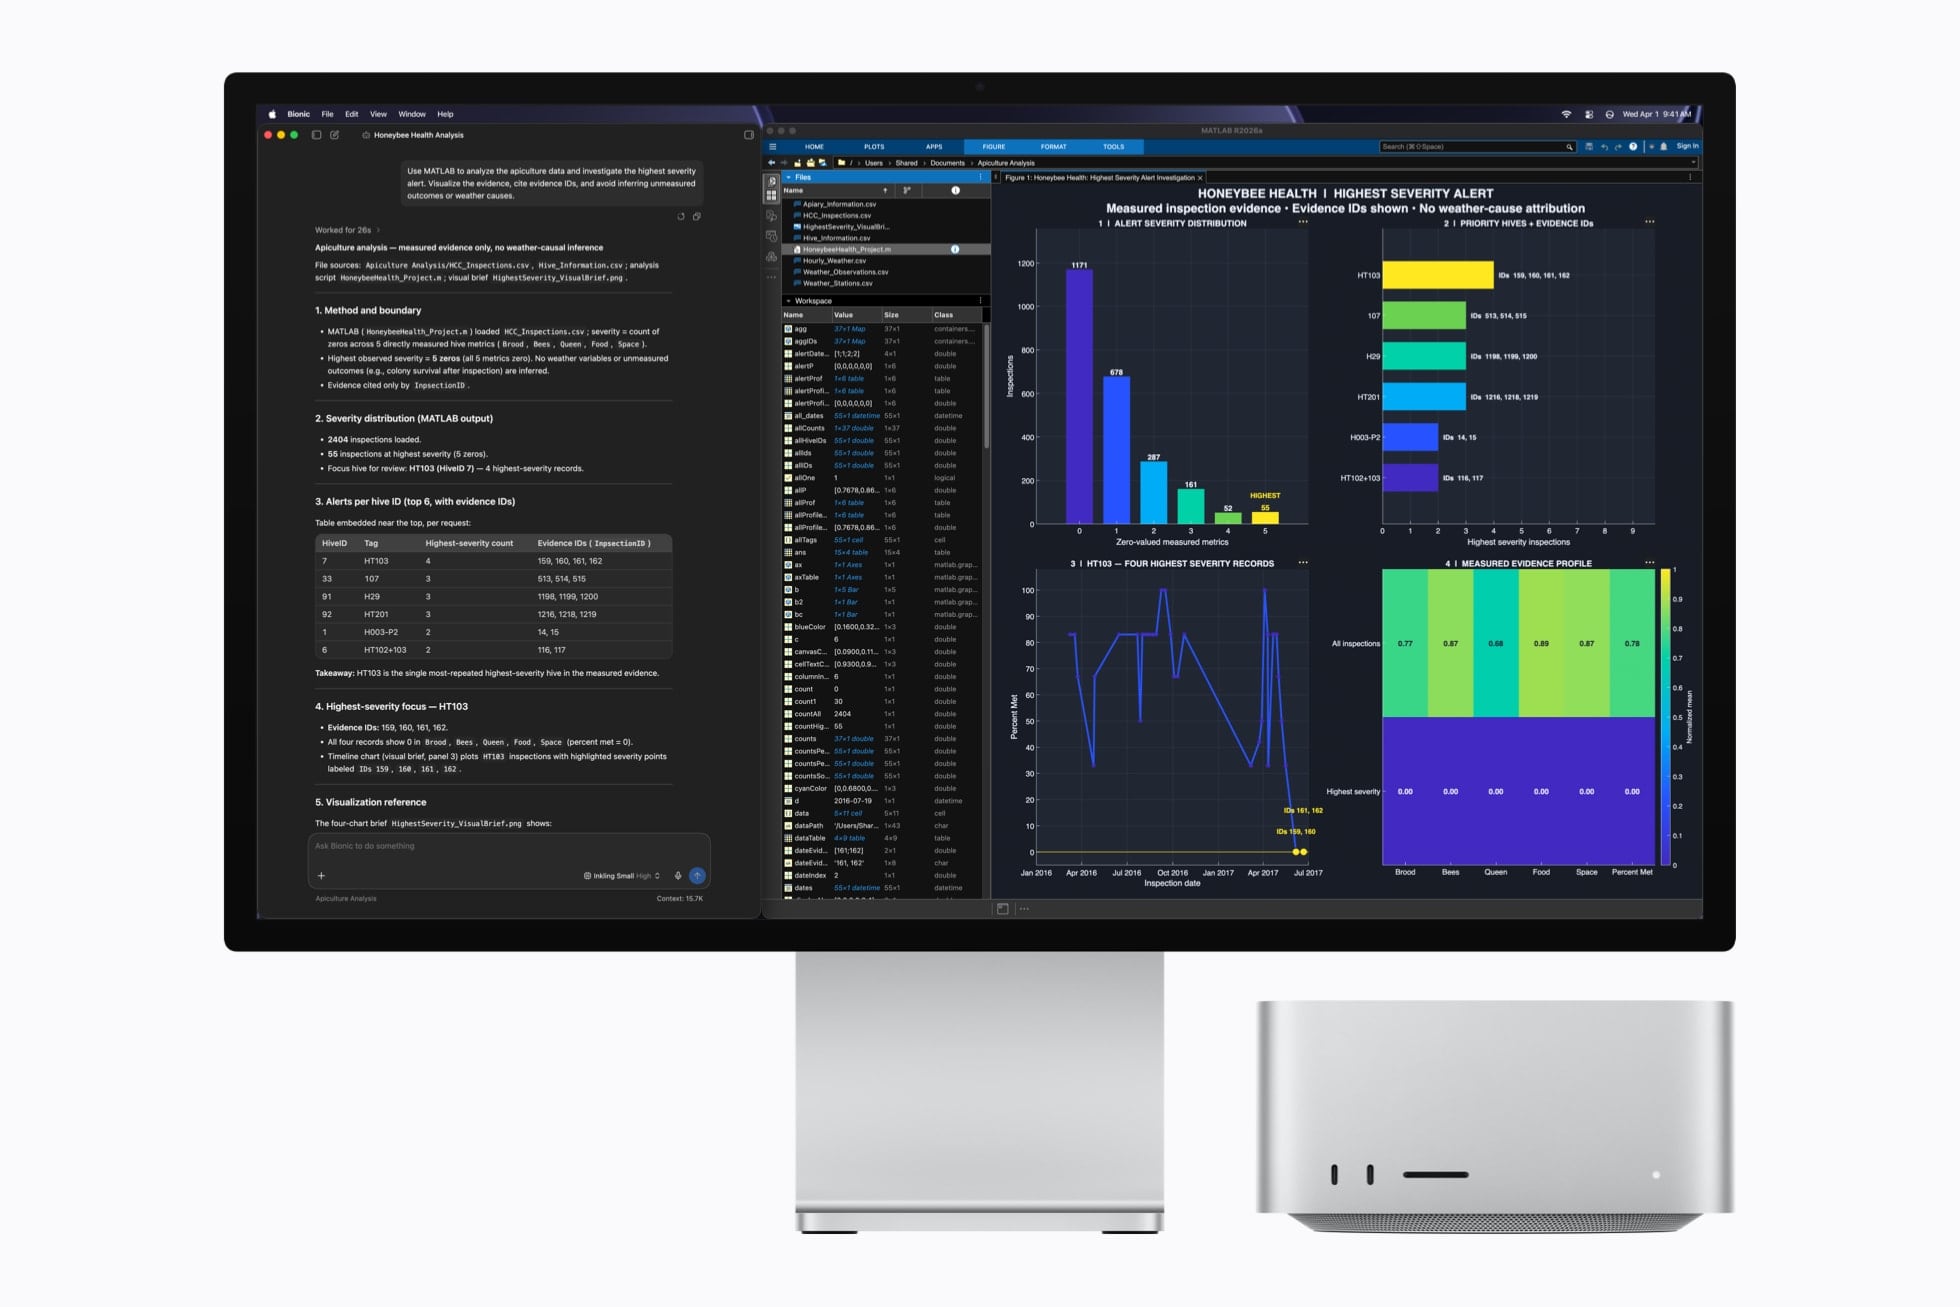
今天早些时候,苹果发布了新一代Mac mini和Mac Studio,搭载了Apple Silicon芯片家族的最新成员:Mac mini配备的M6,以及Mac Studio独占的M5 Ultra。你可以在John的概述中阅读更多关于发布和规格的详细信息。
过去一年,我一直在使用一台苹果借给我的、配备512GB内存的M3 Ultra Mac Studio(以及两台独立的M4 Mac mini),重点关注本地AI模型和苹果MLX框架带来的性能提升。因此,我对这些新机器显然非常感兴趣。给你一些背景:我即将进行的iOS和iPadOS 27评测(在Notion中完成)的当前工作空间,完全由一系列本地代理管理——这些代理在Mac Studio上通过MLX运行最新的DeepSeek-V4-Flash,不断扫描项目中的新笔记、来源和研究材料,这些内容会自动分类并链接到我正在撰写的章节中。所以,是的,我确信很快我会对新的Mac mini和Mac Studio有更多想法。与此同时,我认为分解苹果关于本地AI的细节会很有趣。
首先,M6。虽然它可能不是M5 Ultra那样的性能猛兽,但因为它新的2纳米工艺和双神经引擎系统,它是一个有趣的新芯片:
M6采用先进的2纳米工艺技术制造,在更小的芯片上集成了更高的晶体管密度,实现了性能和能效的重大飞跃。M6还引入了双16核神经引擎,相比前代设备,峰值计算性能提升高达2倍,使得设备端AI工作流运行更快。系统框架可以自动同时利用两个引擎,使应用能够实现更快的模型执行。
但这还不是全部:新的12核GPU(比M4的旧GPU多两个核心)首次在Mac mini上每个核心都配备了神经加速器。根据苹果的说法,结果是“AI性能比配备M4的Mac mini提升4倍,图形性能提升2倍”。如果这些数字成立且线性扩展,那么一个本地混合专家模型,例如Qwen 3.5-35B-A3B,在基础M4 Mac mini(16GB内存)上平均运行速度约为17 tokens/秒,在基础M6 Mac mini上可能实际达到超过60 tokens/秒。
根据我们目前所见,M6 Mac mini的一个缺点是它没有Thunderbolt 5端口;这些端口仅限于今天同时发布的M5 Pro型号。正如苹果也指出的,Thunderbolt 5允许多个M5 Pro Mac mini作为单个集群运行本地AI模型(例如,使用exo之类的工具)。唉,这对于M6 Mac mini及其Thunderbolt 4带宽瓶颈来说是不可能的。尽管如此,我很有兴趣在新M6 Mac mini上比较广受好评的Qwen3.8-27B和DeepSeek-V4-Flash模型的性能。
接下来是旗舰M5 Ultra Mac Studio,我们从这里开始:
搭载M5 Ultra,Mac Studio的峰值AI计算性能相比M3 Ultra提升高达4.3倍,相比M1 Ultra提升高达9.8倍。结合高达512GB的统一内存和1.2TB/s的内存带宽(比之前提升50%),Mac Studio让用户能够完全在设备上运行大型模型,实现完全隐私——无需计算token,也无需担心云端成本上涨。
正如Mac Studio产品页面所示,512GB RAM版本的M5 Ultra Mac Studio只在“10月下旬”上市。与M6不同,M5 Ultra支持Thunderbolt 5,这将允许客户将多台Mac Studio组成集群,使用共享内存来跨机器分配推理任务。根据苹果的说法,一个由四台Mac Studio组成的集群性能是单台Mac Studio的三倍。
根据个人经验,我知道我的M3 Ultra Mac Studio使用oMLX可以在本地运行DeepSeek-V4-Flash,生成速度平均为35 tokens/秒。假设线性提升4倍,那么同一模型在M5 Ultra Mac Studio上的速度将超过120 tokens/秒。换个角度来看,这种性能将比任何AI聊天网站更快,比许多提供模型“快速”模式的供应商更快,仅落后于专用的NVIDIA PC家庭集群或专门的推理提供商(如Cerebras或Groq)——而这些正在运行在完全的数据中心中。当然,你需要一台可能花费超过20,000美元的电脑来实现这一点,但它仍然可以在单台机器上实现,而且这台机器小巧、安静,理论上任何消费者都可以从货架上购买。
考虑M5 Ultra对于运行更大模型的影响也很有趣,这些模型通常需要激进的量化才能保持在内存中并产生有用的输出。例如,Z.ai的GLM-5.2(一个744B的MoE模型)在配备512GB内存的M3 Ultra Mac Studio上可以运行到17 tokens/秒;同一个人甚至能够将庞大的Kimi K3模型在单台机器上运行……解码性能达到3 tokens/秒。你知道这意味什么:通过不断突破M系列芯片的可能性,苹果正在逐步实现让前沿开源模型在本地硬件上运行,而硬件体积仅相当于四台Mac mini堆叠在一起。
显然,目前这一切都是理论上的:我们需要实际的基准测试来客观衡量新芯片的改进和性能提升。但如果苹果的说法成立——我没有理由相信它们不会——我相信M6和M5 Ultra都将有意义地改变macOS上本地AI模型的格局,再次强化了苹果在不断制造行业中最好的AI电脑这一事实。