
M5 Ultra Mac Studio 评测:本地 AI 智能体的梦想之机
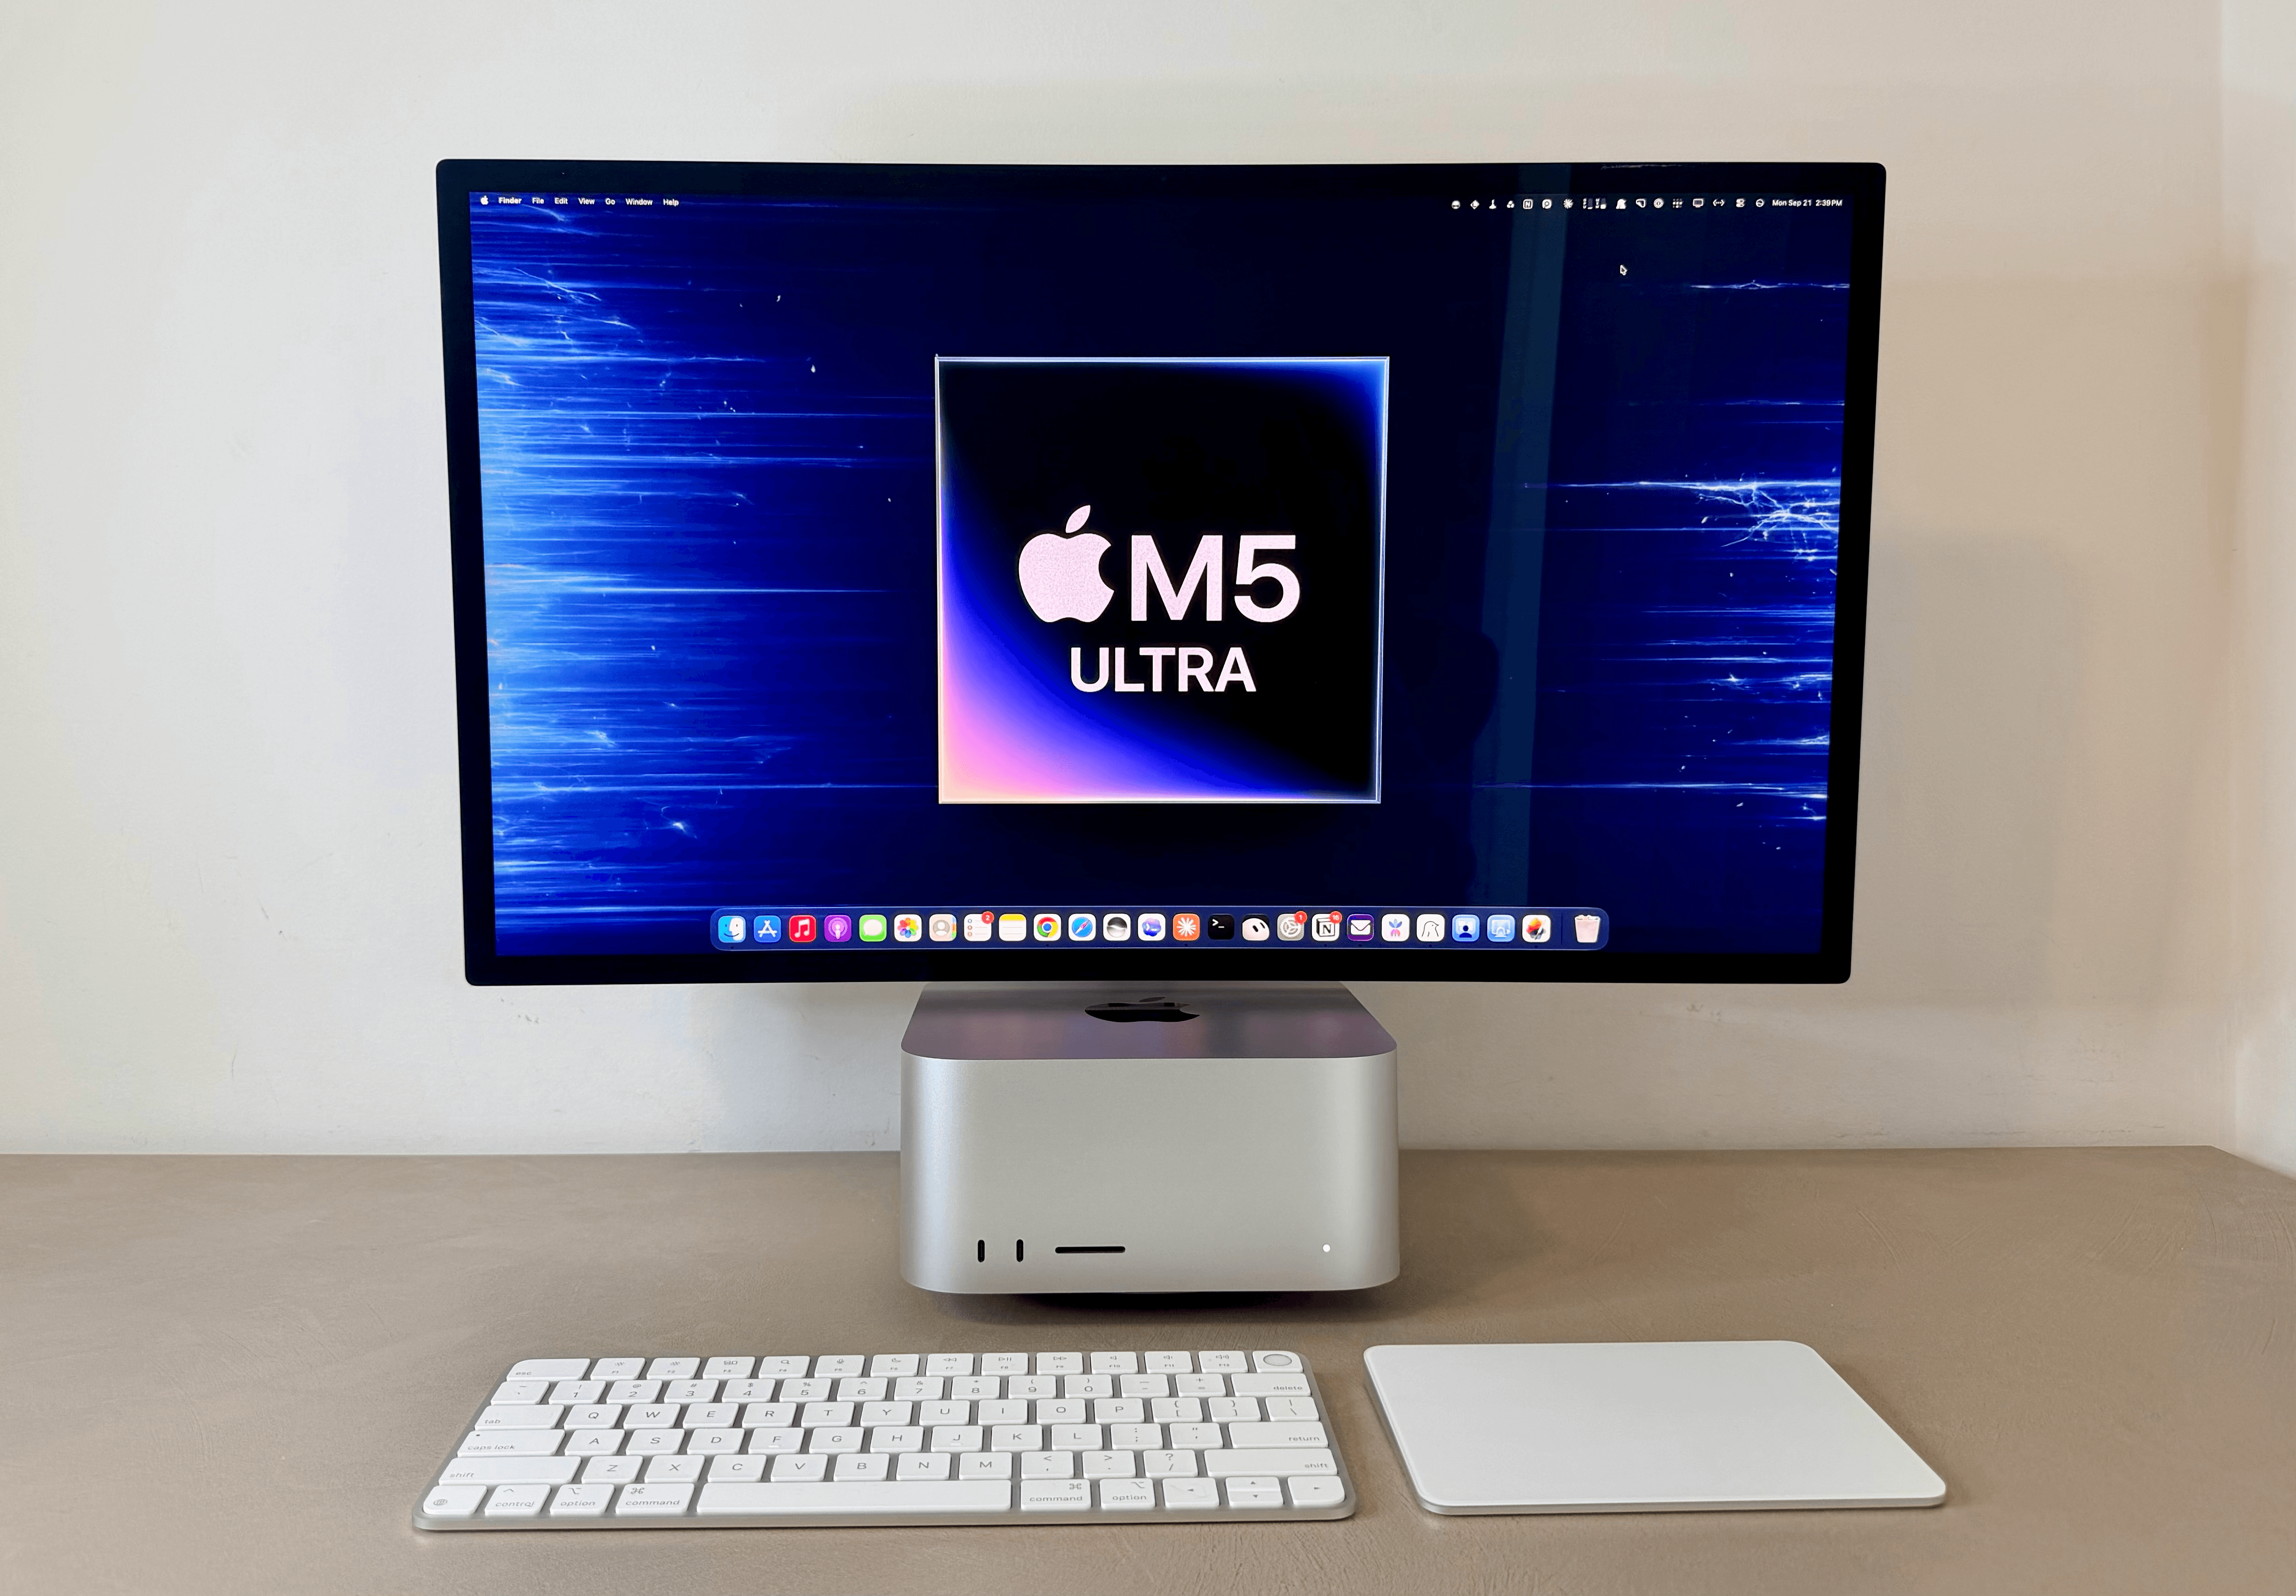
过去几天,我一直在测试(目前)顶配的 M5 Ultra Mac Studio,配备 256 GB 内存。
我直接说重点:M5 Ultra Mac Studio 是本地 AI 智能体的梦想之机。这台电脑让你能够以出色的性能运行由本地模型驱动的个人助理,而且没有任何额外的云端费用。如果你之前对用本地模型测试 OpenClaw 或 Hermes Agent 持怀疑态度,因为它们的智能和速度与云模型相比简直差得十万八千里——这台 Mac 会改变你的想法。
从上周四开始,我一直在将这台 Mac Studio 与其前代产品——512 GB 内存的 M3 Ultra——以及我自己那台搭载 RTX 5090 的台式游戏 PC 进行对比。就其体积、价格、散热表现而言——更不用说 Apple 对统一内存的处理方式——M5 Ultra Mac Studio 从根本上改变了我对本地运行模型的看法,以及它们现在能实现什么。当然,RTX 5090 凭借更高的内存带宽,仍然比 M5 Ultra 略胜一筹。但考虑到我那台 PC 的巨大体积,以及它的热量和噪音,我宁愿每天都用 M5 Ultra Mac Studio。它恰好也是一台 Mac,操作系统好看又好用,还有一个充满活力的应用生态。(Windows 粉丝们,抱歉,但微软的软件永远不会得到我的同情。)
正如我将在本文中探讨的那样,在 M5 Ultra Mac Studio 上运行最新的 Qwen3.8-Flash-Next 模型,体验如此出色、速度如此之快,我已经将它设为 iOS 版 Open Minis 和 Hermes Agent 中的默认模型。没错:我最常使用的个人助理——实际上比 Siri AI 还频繁——现在完全由 Mac Studio 上本地运行的模型驱动。此外,得益于 M5 Ultra 更快的 GPU 和更高的内存带宽,这些智能体开始响应的速度更快,在更大的上下文窗口中也能保持速度,并且可以运行长时间的多轮循环,而不会随着会话增长而慢如蜗牛。正因为如此,我还在 Mac 上的 Codex 应用中使用本地模型——无论是作为主线程,还是作为由 GPT-6 Astra 编排的子智能体——而且体验非常好。
我应该事先说明,我不是职业 AI 开发者:我不训练模型,也不做微调。我骨子里是个喜欢动手鼓捣的人,到目前为止已经摆弄本地 AI 模型一年多了。今年夏天,我在一个正在进行的大项目上全力投入了本地 AI 的使用,我将在下一节中解释。
我写这篇文章的目标,是为你提供两样东西的结合:基于我四天测试中运行的(大量)测试得出的数字和可视化图表,以及我对本地 AI 应用到自己工作流程中的实际用例的说明,以及我如何为 MacStories 完成工作。
让我们开始吧。
为什么选择本地 AI?
让我们先直面房间里的大象:既然云端前沿模型更好而且通常更快,为什么还要费心搞本地 AI?
这是个合理的问题。你需要昂贵的硬件来运行这些模型,而当你收回投资的时候,你本可以用最贵的 Anthropic 订阅好几年,还能省下钱来,并且获得更好的性能回报。
不同的人对这个问题会有不同的答案。有些人可能会说,他们使用本地模型是因为隐私:他们宁愿依靠本地智能来处理敏感数据和文档,也不愿把任何东西上传到外部云端。另一些人可能会争辩说,这纯粹是因为酷——而我不反对这种说法。对一些人来说,这是与工作相关的任务:如果你是 AI 开发者,拥有一个优秀的本地环境来训练自己的适配器或微调模型,是很有意义的。
对我来说,本地 AI 之旅的特点是“很酷,为什么不呢”的因素,加上对隐私和成本的考量。
正如我本周晚些时候将与 Club MacStories 会员分享的那样,今年夏天我为 iOS 和 iPadOS 27 评测所做的研究和写作环境,正是由本地 AI 驱动和实现的。六月份,我创建了一个内部应用,名为 Desk,用来组织与 iOS 和 iPadOS 27 相关的数百条笔记、会议记录、PDF 文档和剪藏的网页,以及评测的各个章节。到过程结束时,这个项目包含 310 个文档。在 Desk 中,一个智能体团队——全部基于 DeepSeek V4 Flash,加上用于 PDF 的 olmOCR——全天候运行了 99 天,执行以下任务:
- 转录我最喜欢的 WWDC 会议(使用 summarize 加 LLM 处理) - 从剪藏的网页、会议、PDF 指南和我自己的笔记中提取 iOS 和 iPadOS 27 的功能 - 跨不同来源交叉引用功能,并跟踪哪些功能属于评测的哪个章节 - 从我上传的截图里提取功能和 bug - 使用 Notion API 在多个数据库中组织所有内容
当我在六月初开始使用这个设置时,我很快意识到,对于这种始终在线、持续运行的后台任务,依赖 OpenAI 或 Anthropic 的 API 将是……至少可以说是成本高昂的。所以我转向了本地 AI,结果就是你在 MacStories 上读到的 iOS 和 iPadOS 27 评测。它完全由我以老式的人类方式撰写。但整个研究栈、笔记之间的深链,以及跟踪新功能和测试版,全部由我的智能体在 Mac Studio 上本地完成,总成本为 0 美元。
如果你不觉得这很酷,或者不认为这是一个值得探索的强大概念,那么这篇文章可能不适合你——我理解。摆弄这些模型很繁琐,而且我绝不会向那些(合理地)只想付 20 美元使用 Claude Cowork 的人推荐这种东西。这种设置,按定义,就是目前 AI 工作流的最前沿。
不过,如果你站在光谱的另一端,如果你觉得这种东西很酷……那么让我告诉你:M5 Ultra Mac Studio 是 MLX 驱动的本地模型性能的一次巨大飞跃,我有几个例子可以证明。
提示处理和生成的飞跃
正如你可能从公告和我最初的报道中看到的那样,M5 Ultra Mac Studio 看起来与其取代的 M3 Ultra 型号完全相同,但它配备了全新的 Apple 芯片架构,使用 UltraFusion 连接两颗双 die 的 M5 Max 芯片,形成四 die 架构,这在 Apple 生态中是首次。就本地 AI 工作负载而言,有两个领域我们必须关注(自从去年我报道 M5 iPad Pro 的本地 AI 能力以来,我一直在关注):GPU 和内存带宽。
M5 Ultra 拥有下一代 GPU,80 个核心,每个核心都带有一个神经加速器,使其 AI 峰值 GPU 算力比 M3 Ultra 高出 4.5 倍。至于内存,Apple 的统一内存架构仍然和以前一样最高支持 512 GB(尽管那个型号要到十月底才会推出),但其带宽已从 819 GB/s 跃升至 1.2 TB/s,比 M3 Ultra 高出 50%。
了解了这些数字后,我开始将 M5 Ultra 与 512 GB 内存的 M3 Ultra 以及我的 RTX 5090 进行对比测试。我将在下面分享更多测试细节,但简而言之:使用 M5 Ultra,你等待模型读取提示并开始生成响应的时间大大减少;而当它开始回答时,文本出现的速度比 M3 Ultra 上快得多。仅这两项改进,就让这台机器能够胜任现代的智能体循环——这种循环需要与模型快速迭代,因此也需要更大的上下文窗口。
在我日常使用 M5 Ultra 上运行的智能体时,token 预填充(即提示被处理的速度)和 token 生成方面的改进,是我立刻注意到的变化。在使用 iOS 版 Open Minis 并排比较 M3 Ultra 和 M5 Ultra 上运行的模型时,M5 Ultra 在生成响应方面平均比 M3 Ultra 快约 70%。正如我们稍后将看到的,让 Qwen3.8-Flash-Next 这样的模型在短提示上达到每秒 100 token,并且在 64K 到 256K 上下文的支撑下仍以每秒 60 到 85 的速度书写,这绝非儿戏。它实现了你和模型之间那种智能体式的来回互动,用起来感觉非常好,尤其是在涉及工具调用的时候。
然而,更让我印象深刻的是 token 预填充方面的性能提升。当你使用 Hermes 或 Codex 这样的智能体助手时,模型会收到一整块指令,包括系统提示、用户个性化和会话记忆、技能和 MCP 描述等等。有些智能体在精简发送的指令方面做得比其他好,但一般来说,每当你使用现代智能体时,你并不是从空的上下文窗口开始的。正因为如此,我一直无法在这波新的智能体上持续使用本地模型:它们能工作,但我会对着空屏幕和加载指示器盯上一阵子,模型才会开始生成响应。而且在循环的每一轮,性能都会变得更差(因为会话的上下文更大了),我又得等更长时间。
在我的测试中,提示处理速度平均比 M3 Ultra 提升 150%——比我之前的设置提高了约 2.5 倍。仅这一项改变,就让本地模型成为 Open Minis 和 Hermes Agent 等应用中的可靠选择。当我让 M5 Ultra 上的 Flash-Next 用 RemCTL 获取我本周的任务时,我不必等待智能体处理我的提示和 Open Minis 的请求:只需几秒钟,它就开始工作,进行推理、执行工具调用等等。而当我在一个大型项目上工作时,比如下面这个体素罗马斗兽场演示,模型能够快速处理多轮循环,调度和协调子智能体,并且在线程变长时保持每秒 60 到 85 token 的速度。
我非常相信,除了回答问题之外,还能以智能体方式执行任务的助手——但要想用起来舒服,它们必须快。在过去的几个月里,我用 Open Minis 测试了几家“精品”云提供商:Inco,以超过 300 TPS 的速度服务 Kimi K3;Cerebras,以高达 1,800 TPS 的速度运行 Qwen3.8-27B;还有 Fireworks 和 Baseten 之类的,都突破了 150 TPS 的壁垒。所有这些提供商在 Open Minis 和 Hermes 中使用起来感觉都非常好,但它们很贵(毫不夸张地说,上周我 10 分钟就烧掉了 20 美元的 Inco 积分),而且,当然,使用它们时我所有的数据都会去……某个地方。当我用 Flash-Next 和我正在创建的一系列 Apple CLI 工具启动 Open Minis 时,一切都保持在本地,在我能看到、想重启就重启的那台电脑里。
最重要的是:像 Flash-Next 这样的模型可以“足够小”,以更高的量化级别在 256 GB 的 M5 Ultra 上运行(我可以在内存中完整运行 5-bit;6-bit 和 8-bit 可以利用这种新架构将 n-gram 表卸载到 SSD),但也足够智能,能够维持长线程和多次智能体工具调用。
就我的口味而言,5-bit 量化在这版 Ultra 上达到了最佳平衡点,在智能、性能与内存消耗之间取得了平衡。但我已经知道,如果我能测试 512 GB 的 M5 Ultra,我会非常有兴趣测量 8-bit 量化在无需 SSD 卸载的情况下的性能。
我还没有花太多时间尝试将各种项目的编码任务交给本地模型,但我做了几个有趣的实验。凭借这种性能,特别是考虑到能够在 256 GB 内存的 oMLX 中堆叠多达三个并发的 Flash-Next 会话与子智能体(稍后详述),我现在可以现实地考虑将更简单的编码任务交给本地模型,并让前沿云模型审查它们的工作。例如,我能够在 Codex 中设置 Qwen3.8-Flash-Next,这让我可以在 Codex 框架中使用本地模型。这意味着我可以让一个 GPT 主模型编排本地子智能体,让 Flash-Next 协调它自己的子智能体,甚至可以用 iOS 上的 Codex Remote 从手机直接使用这个模型。
我很期待看到真正开发者在拿到 M5 Ultra 后对这一话题的更多讨论。随着开放权重模型在消费级硬件上的表现已经超越约 10 个月前被认为是“前沿”的水平,而且 M5 Ultra 上的性能使智能体编码变得可行,我认为我们很快会看到 MLX 社区一些令人着迷的实验。
M5 Ultra vs. RTX 5090
正如你将在本文后面的可视化图表中看到的那样,NVIDIA 的 RTX 5090 仍然比 Apple 的 M5 Ultra 更快,尽管它的显存“只有”32 GB,原因有两个。
提示处理速度由算力决定:模型在一个巨大的矩阵乘法中读取整个提示,这正是 NVIDIA Tensor Core 的用武之地。Apple 新的神经加速器(M5 Ultra 的 80 个 GPU 核心中各有一个)缩小了差距,但无法完全弥补。在 6,000 token 的提示上,M5 Ultra 的读取速度约为每秒 1,700 token;而 5090 在 LM Studio 中使用我测试的 Qwen 模型时,达到了惊人的每秒约 3,000 token。另一方面,token 生成由带宽决定:模型一次生成一个 token,每次都要把整个模型从内存中取出来,因此 5090 的 1.79 TB/s 对比 M5 Ultra 的 1.2 TB/s,使其在任何提示大小下都稳定领先约 25%。5090 缺少的是内存:在 256K 时,5090 只能完成 8-bit 注意力缓存。32 GB 显存也就只能走这么远了。
然而,这种比较有两个问题。首先,虽然 5090 在较小的模型上确实仍然胜过 M5 Ultra,但它缺乏统一内存池,这意味着如果我想以极快的速度运行模型,就只能用 GPU 里那 32 GB 的显存。当我想运行任何超过 32 GB 的东西时(比如前面提到的更高 Flash-Next 量化),5090 就必须通过 PCIe 将模型层卸载到(慢得多的)系统内存,这可不是人过的日子。
其次,我的游戏 PC 与放在桌面上的 Mac Studio 相比是庞然大物——而且我用的是 Lian-Li A3 机箱的紧凑型装机。更不用说在高上下文窗口下运行本地模型时它有多吵多热:一些基准测试跑完后我走进办公室,那里比我公寓的其他地方热得让人不舒服。相比之下,我桌上那台“小巧”的 Mac Studio 摸起来是温热的,但明显比我的 5090 安静,风扇没有转得那么快或那么响。最重要的是,得益于 Apple 芯片的统一内存,它能让我在本地运行 GLM-5.3-Flash 这样更大的模型,性能还不错。在我日常使用中,当我一直运行 Flash-Next oQ4e 时,除非我把耳朵直接贴在电脑顶部,否则我永远听不到桌上 Studio 的风扇声。
从 Apple 近年来的进步来看,如果不久的将来出现一款在内存带宽上超越 5090 的 M7 Ultra,我也不会感到惊讶。但那是另一个故事了。
关于测试的说明
最后,在进入原始数字和图表之前:我是怎么测试所有东西的?
自动化测试使用我用 GPT-6 Astra 构建的测试框架进行。它协调了多个 Codex 实例,分布在我的 M3 Ultra 和 M5 Ultra Mac Studio 上,以及我装有 Codex Windows 版和 Computer Use 的 PC 上。在 macOS 上,我选择 oMLX(版本 0.7.0.dev2)作为 MLX 模型的本地后端,并在 macOS Golden Gate 27.0 上运行了 Qwen3.8-Flash-Next-oQ4e-mtp、GLM-5.3-Flash-MLX-mixed-4_8bit 和 Qwen3.8-27B-oQ4e-mtp 进行了大部分测试。在 Windows 上,我使用 LM Studio 和 Qwen3.8-27B-GGUF,配备 CUDA 12 运行时,并将全部 66 层卸载到 GPU 进行纯 GPU 测试,另外还有将模型拆分到 GPU 和系统内存的单独测试。
除了用 Open Minis 原生子智能体进行的单独实验外,我还使用了一个自定义测试框架来测量并发请求,以及涉及一个主模型和多个辅助模型的工作流,其中 oMLX 服务 Mac 端模型,LM Studio 服务 Windows 端模型。
数字由 Astra 在四天内收集,随后由 Claude Fable 5.1 和 Opus 5 使用 Anthropic 即将推出的 Projects 功能进行了可视化,我在撰写本文时得以提前测试该功能。交互式可视化基于 MacStories 的风格,用纯 HTML 和 CSS 构建,并包含本人的评论和注释。
我制作以下交互式小部件的目标,不仅是为了帮助你更清楚地理解数字,也是为了可视化这些统计数字在实践中意味着什么。我对那些模拟不同每秒 token 数感受的小部件非常满意,因为这个指标通常很难可视化。我希望这些动画图表能比你可能在其他地方见过的普通“静态”图表更有用(那些也包含在下面)。
可视化 M5 Ultra
面向本地 AI 智能体的 M5 Ultra
到这里应该很清楚了:M5 Ultra 的性能提升是真实的,它们展示了 Apple 在定制芯片和统一内存架构上的投资,正在为喜欢动手的人和开发者带来红利。
尽管做了这些测试,我觉得自己只是触及了 M5 Ultra 及其 256 GB 内存可能性的皮毛。随着更多开发者和开源维护者让他们的双手(和智能体)用上 M5 Ultra,我相信我们会看到更多量化方面的优化,让更大规模的模型在这台电脑上以卓越的性能运行。例如,我甚至没有时间测试 DwarfStar——一个引人入胜的项目(意大利制造的!),它让各种 Mac 配置都能用更少的内存运行本地前沿模型;我也没有时间查看 Inco Splash,一个专为 Apple 芯片和特定模型设计的新推理引擎。同样,我也没有时间测试 Exo,它的 RDMA 实现(理论上)应该能让我通过 Thunderbolt 5 在 M3 Ultra 和 M5 Ultra 之间拆分并分布式推理,同时在其前面运行一个 OpenAI 兼容服务器,为本地智能体提供 API 服务。
而且,我当然无法想象配备 512 GB 内存的高端 M5 Ultra 在扩展本地可运行模型的规模方面会带来什么。我希望最终也能测试它。
在这次的实验结束时,我有一个简单而切实的结果:M5 Ultra 让我能以令人难以置信的性能运行本地智能体,减少了盯着空白屏幕的时间,一切都发生在我桌上那台紧凑、冷静、安静的单台机器上。
这在几年前似乎是不可想象的。但现在,我们做到了。